Salesforce hat mit Koa ein eigenes Modell - im Paper liegt es hinter GPT-5.5 und Opus 4.8
15 September 2026Dieser Artikel wurde mithilfe einer Lösung erstellt, die unter menschlicher Aufsicht eine Farm von KI-Modellen unter anderem für Recherche, Verifizierung, Korrektur und Übersetzung orchestriert.
Ein Beitrag mit dem Titel „Salesforce just built its own AI model“ macht seit Dienstag auf LinkedIn die Runde, auch in deutschen Vertriebsteams. Er liest sich wie das Ende der Abhängigkeit von OpenAI und Anthropic. Es lohnt sich zu lesen, was Salesforce am selben Tag in zwei Dokumenten veröffentlicht hat, denn jedes sagt etwas anderes.
Was angekündigt wurde
Koa ist ein reasoning model für die Arbeit in Agentforce, der Agentenplattform von Salesforce. Zu den Aufgaben gehören etwa: Verkaufschancen qualifizieren, Tickets zuweisen und nächste Schritte planen. Das Modell entstand aus dem Post-training von Nemotron 3 Super, Nvidias offenem Modell mit 120 Milliarden Parametern (12 Milliarden aktiv), per Reinforcement Learning auf fünf Servern mit B200-Chips. Die Trainingsdaten sind synthetische Szenarien und öffentliche Daten, ohne Kundendatensätze: simulierte Kunden, darunter „irate customers that call into the customer service center“ (wütende Kunden, die im Servicecenter anrufen), und simulierte Vertriebler, die Abschlüsse machen. Rohan Kumar, President für Plattform und Engineering: „Not a single byte of customer data was used.“ Salesforce behält die Kontrolle über die Gewichte und betreibt das Modell auf eigener Infrastruktur. Intern arbeitet Koa bereits als Agent in Slack, Pilotprojekte bei Kunden starten gerade erst (Nvidia nennt Oktober), unter anderem bei der Formel 1, Xero und UChicago Medicine. Allgemein verfügbar sein soll es „winter 2026 in U.S. regions“. Einen Preis nannte das Unternehmen nicht, einen Termin für Europa auch nicht.
Zwei Dokumente, zwei Wahrheiten
Die Pressemitteilung: Im CRM-Benchmark von Salesforce heißt es, Koa „already matches or exceeds leading model performance on CRM actions with three times fewer errors“. Die Produktseite ergänzt „Precision: +11%“, „Reliability: 2.1x“ und „Context: 15%“, ohne die Modelle zu nennen, mit denen Koa verglichen wurde.
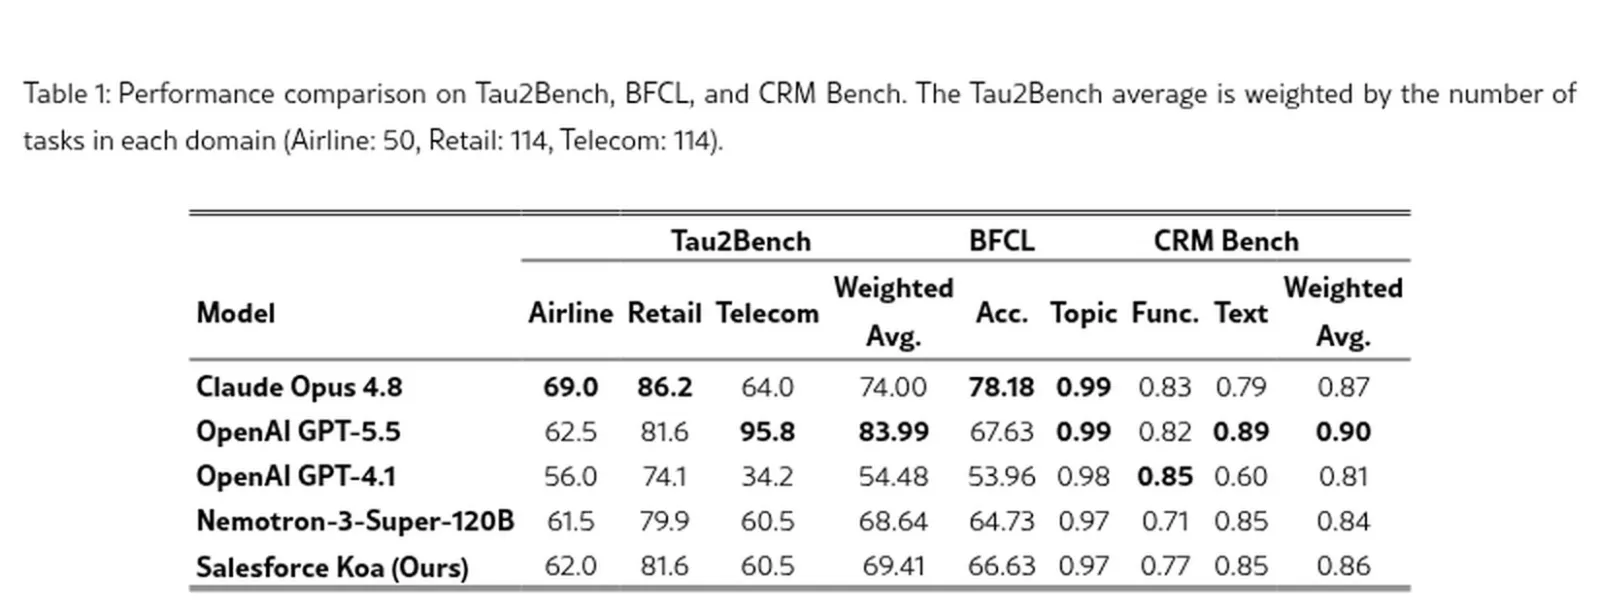
Das Paper „Salesforce Koa: An Enterprise Language Model for Agentic Tool Use“, geschrieben von 25 Salesforce-Autoren und am Montag bei arXiv eingereicht, enthält eine Tabelle. Im CRM Bench kommt GPT-5.5 auf 0,90, Claude Opus 4.8 auf 0,87, Koa auf 0,86, das Basismodell Nemotron auf 0,84 und GPT-4.1 auf 0,81. Das Fazit der Autoren: Koa „surpasses a strong proprietary baseline (GPT-4.1) while remaining below the strongest frontier models“. Der messbarste Gewinn aus dem Post-training ist die Trefferquote bei Tool-Aufrufen im CRM Bench, sie steigt von 0,71 auf 0,77. Die Formulierung „three times fewer errors“ steht nirgends im Paper, und kein Zahlenpaar der Tabelle ergibt einen dreifachen Unterschied. Es gibt weitere Widersprüche: Die Pressemitteilung beschreibt supervised fine-tuning und Reinforcement Learning, das Paper schreibt, das fertige Modell sei durch Reinforcement Learning direkt auf dem Basismodell entstanden, ohne SFT-Stufe. Jason Andersen von Moor Insights: „That is Salesforce grading its own test, so I would treat the specific numbers as a claim to watch rather than settled fact.“
Was sich wirklich geändert hat
Nicht, dass Koa das beste Modell wäre. Sondern dass es existiert. Jayesh Govindarajan, EVP of Salesforce AI, gegenüber TechCrunch: „reasoning has always been something that we've relied on the frontier model providers for. Until now.“ Vor drei Wochen kündigte Salesforce Claudeforce an: Claude ist das Standardmodell in Slack und in den Agentforce-Agenten Coworker und Vibes, und laut Benioff gibt das Unternehmen in diesem Jahr rund 300 Mio. USD für Anthropic-Tokens aus, fast ausschließlich für Coding (bestätigt hat die Summe keines der beiden Unternehmen). Koa ersetzt nichts, es wird zum vierten Modellanbieter, den man im Setup auswählen kann. Aber ein Unternehmen mit 30.000 Agentforce-Kunden hat gezeigt, dass ein offenes Modell, synthetische Daten und ein paar Dutzend GPUs reichen, um ein eigenes reasoning model zu bauen. Warum Nemotron? Govindarajan: „We have no idea what Qwen trains on“, und ein amerikanisches offenes Modell der frontier-Klasse mit klarer Datenherkunft gab es bis dahin nicht. Jensen Huang auf der Bühne, im Bericht von Nvidia: Der Anteil offener Modelle sei von 30 % Anfang vergangenen Jahres auf rund 70 % gestiegen.
Außerhalb von LinkedIn war die Resonanz dünn. Zwei Threads auf Hacker News mit je zwei Punkten, den TechCrunch-Artikel mit der Überschrift „everything the AI labs should fear“ hat nicht einmal jemand eingereicht. Nvidia hat das Wort „Koa“ in keinem einzigen Post auf X geschrieben. Auf r/salesforce hat der einzige Thread 1 Punkt, und die Kommentierenden lesen „27 years of CRM intelligence“ auf ihre Weise: „so what they are saying is that they used the last 3 decades customers data to train their proprietary model? No one saying anything?“ Salesforce sagt nein, und das Paper wiederholt es. Aber so sieht Vertrauen nach zwei Jahren Agentforce-Versprechen aus.
Für ein Unternehmen in Deutschland ändert sich vorerst nichts: Für Europa gibt es weder einen Termin noch einen Preis, allgemein verfügbar sein soll Koa zuerst in den US-Regionen. An der Sprache liegt es hier ausnahmsweise nicht - Nemotron 3 Super unterstützt offiziell Deutsch, Französisch, Italienisch, Spanisch, Japanisch, Chinesisch und Englisch, viele kleinere Sprachen der EU dagegen nicht. Offen ist etwas anderes: unter welchen Bedingungen Salesforce das Modell in den europäischen Hyperforce-Regionen betreiben will und wie sich das mit der DSGVO und dem EU AI Act verträgt. Dass Koa auf eigener Infrastruktur von Salesforce läuft und ohne Kundendaten trainiert wurde, ist dabei das stärkste Argument des Unternehmens - solange kein Termin für Europa steht, bleibt es eine Ankündigung.
Am Samstag rief der Chef von Anthropic die Labs dazu auf, langsamer zu machen. Am Dienstag zeigte einer ihrer größten Kunden, dass er vorsichtshalber ein eigenes Modell baut. Es heißt Koa, hawaiianisch für „mutig“. So hieß Benioffs Golden Retriever, den das Unternehmen seit Jahren als Maskottchen mit dem Titel „Chief Love Officer“ präsentiert.
Reasoning model - ein Modell, das sein Vorgehen vor der Antwort Schritt für Schritt aufschreibt und Werkzeuge auswählt, statt sofort zu antworten. Post-training - das Nachtrainieren eines fertigen Modells für bestimmte Aufgaben, günstiger als ein Training von Grund auf. Frontier - die zum jeweiligen Zeitpunkt stärksten Modelle, hier GPT-5.5 und Claude Opus 4.8. Agentforce - die Plattform von Salesforce zum Bau von KI-Agenten, abgerechnet wird unter anderem pro Gespräch (2 USD) oder pro Aktion (10 US-Cent).