Salesforce a son propre modèle, Koa : il rattrape les labos, mais pas dans son article
15 septembre 2026Cet article a été réalisé avec une solution qui orchestre sous supervision humaine une ferme de modèles d'IA, notamment pour la recherche, la vérification, la correction et la traduction.
Un post intitulé « Salesforce just built its own AI model » (« Salesforce vient de construire son propre modèle d'IA ») circule sur LinkedIn depuis mardi, y compris chez les commerciaux français. Cela a tout l'air de la fin de la dépendance à OpenAI et Anthropic. Il vaut la peine de lire ce que Salesforce a publié dans deux documents le même jour, parce que chacun livre une version différente.
Ce qui a été annoncé
Koa est un reasoning model destiné aux tâches d'Agentforce, la plateforme d'agents de Salesforce. Ces tâches, ce sont par exemple la qualification des opportunités, l'aiguillage des demandes et la planification des prochaines étapes. Le modèle est né du post-training de Nemotron 3 Super, le modèle ouvert de Nvidia à 120 milliards de paramètres (12 milliards actifs), par apprentissage par renforcement sur cinq serveurs équipés de puces B200. Les données d'entraînement sont des scénarios synthétiques et des données publiques, sans aucun dossier client : des clients simulés, dont des « irate customers that call into the customer service center » (des clients furieux qui appellent le centre de service client), et des commerciaux simulés qui concluent des ventes. Rohan Kumar, président de la plateforme et de l'ingénierie : « Not a single byte of customer data was used. » (Pas un seul octet de données client n'a été utilisé.) Salesforce garde le contrôle des poids du modèle et le fait tourner sur sa propre infrastructure. En interne, Koa fonctionne déjà comme agent dans Slack ; les pilotes chez les clients ne font que commencer (Nvidia annonce octobre), entre autres chez Formula 1, Xero et UChicago Medicine. La disponibilité générale est attendue « winter 2026 in U.S. regions » (hiver 2026, dans les régions américaines). Aucun prix n'a été donné, ni aucune date pour l'Europe.
Deux documents, deux vérités
Le communiqué de presse : dans le benchmark CRM de Salesforce, Koa « already matches or exceeds leading model performance on CRM actions with three times fewer errors » (égale ou dépasse déjà les meilleurs modèles sur les actions CRM, avec trois fois moins d'erreurs). La page produit ajoute « Precision : +11 % », « Reliability : 2,1x » et « Context : 15 % », sans nommer les modèles auxquels Koa a été comparé.
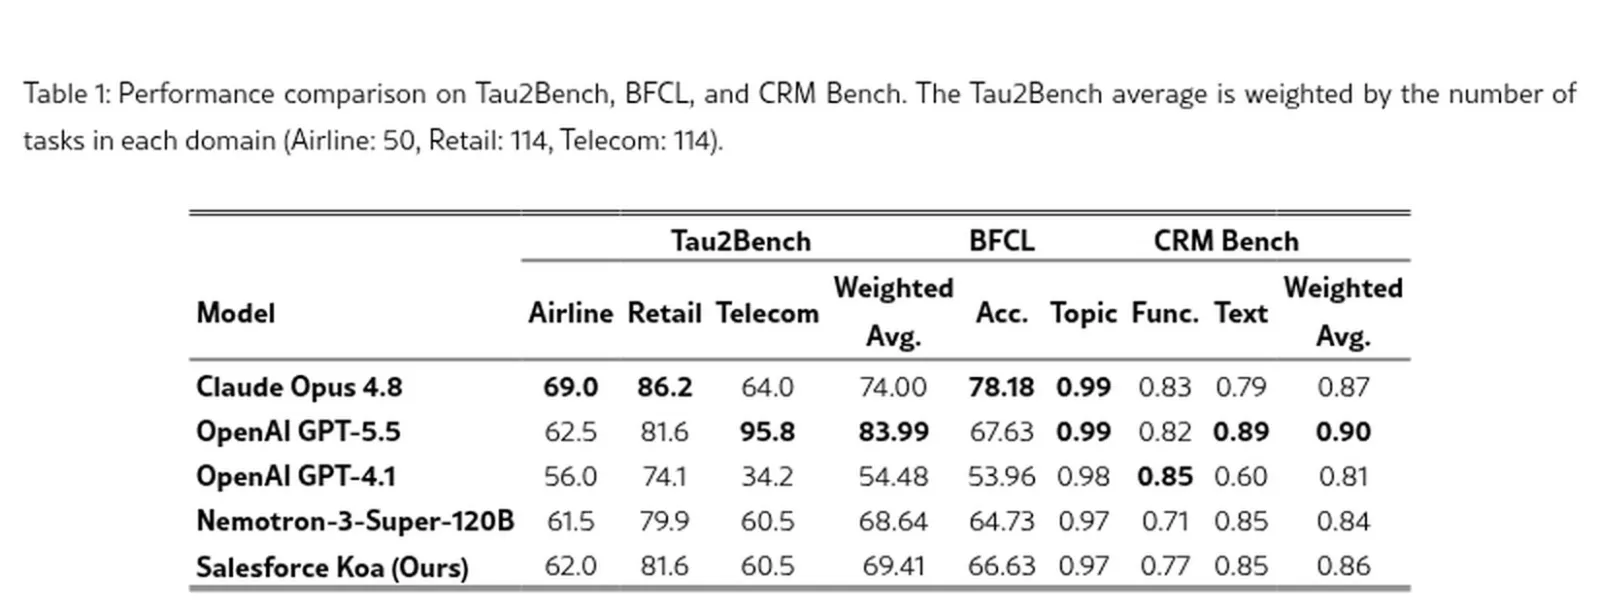
L'article de recherche « Salesforce Koa: An Enterprise Language Model for Agentic Tool Use », signé par 25 auteurs de Salesforce et déposé sur arXiv lundi, contient un tableau. Sur CRM Bench : GPT-5.5 obtient 0,90, Claude Opus 4.8 0,87, Koa 0,86, le Nemotron de base 0,84 et GPT-4.1 0,81. La conclusion des auteurs : Koa « surpasses a strong proprietary baseline (GPT-4.1) while remaining below the strongest frontier models » (dépasse une solide référence propriétaire, GPT-4.1, tout en restant en dessous des modèles frontier les plus puissants). Le gain le plus mesurable du post-training, c'est la justesse des appels d'outils sur CRM Bench, passée de 0,71 à 0,77. La formule « trois fois moins d'erreurs » ne figure nulle part dans l'article, et aucune paire de chiffres du tableau ne donne un rapport de un à trois. Les divergences ne s'arrêtent pas là : le communiqué décrit un supervised fine-tuning suivi d'un apprentissage par renforcement, alors que l'article indique que le modèle fini résulte d'un apprentissage par renforcement appliqué directement au modèle de base, sans étape de SFT. Jason Andersen, de Moor Insights : « That is Salesforce grading its own test, so I would treat the specific numbers as a claim to watch rather than settled fact. » (Salesforce corrige sa propre copie ; je traiterais donc les chiffres précis comme une affirmation à surveiller, pas comme un fait établi.)
Ce qui a vraiment changé
Ce n'est pas que Koa soit le meilleur : c'est qu'il existe. Jayesh Govindarajan, EVP de Salesforce AI, dans TechCrunch : « reasoning has always been something that we've relied on the frontier model providers for. Until now. » (le raisonnement, nous l'avons toujours pris chez les fournisseurs de modèles frontier. Jusqu'à maintenant.) Il y a trois semaines, Salesforce annonçait Claudeforce : Claude est le modèle par défaut dans Slack et dans les agents Agentforce Coworker et Vibes, et selon Benioff l'entreprise dépense cette année environ 300 millions de dollars en tokens Anthropic, presque uniquement pour le code (aucune des deux sociétés n'a confirmé le montant). Koa ne remplace rien : il devient le quatrième fournisseur de modèles au choix dans le Setup. Mais une entreprise qui compte 30 000 clients Agentforce vient de montrer qu'un modèle ouvert, des données synthétiques et quelques dizaines de GPU suffisent pour construire son propre reasoning model. Pourquoi Nemotron ? Govindarajan : « We have no idea what Qwen trains on » (nous n'avons aucune idée de ce sur quoi Qwen est entraîné), et jusqu'ici il n'existait pas de modèle ouvert américain de classe frontier dont la provenance des données est claire. Jensen Huang sur scène, dans le compte rendu de Nvidia : la part des modèles ouverts est passée de 30 % au début de l'année dernière à quelque 70 % aujourd'hui.
En dehors de LinkedIn, l'écho a été faible. Deux fils sur Hacker News à deux points chacun ; personne n'a même soumis l'article de TechCrunch titré « everything the AI labs should fear » (tout ce que les labos d'IA devraient craindre). Nvidia n'a écrit le mot « Koa » dans aucun post sur X. Sur r/salesforce, l'unique fil a 1 point, et les commentateurs lisent les « 27 years of CRM intelligence » à leur façon : « so what they are saying is that they used the last 3 decades customers data to train their proprietary model? No one saying anything? » Salesforce dit que non, et l'article de recherche le répète. Mais c'est à cela que ressemble la confiance après deux ans de promesses autour d'Agentforce.
Pour une entreprise française qui utilise Salesforce, rien ne change encore : la disponibilité générale annoncée ne couvre que les régions américaines, et le reste du monde attend sans calendrier. Ni prix, ni date pour l'Europe. La langue, pour une fois, n'est pas l'obstacle : Nemotron 3 Super prend officiellement en charge le français, aux côtés de l'anglais, de l'allemand, de l'italien, du japonais, de l'espagnol et du chinois. Reste le terrain juridique, et c'est lui qui pèsera sur le calendrier européen. Un modèle que Salesforce fait tourner sur sa propre infrastructure, entraîné sans données client : ce sont exactement les deux points sur lesquels une DSI européenne sera interrogée, où sont traitées les données du CRM et sur quelles données le modèle a été entraîné. Les réponses au regard du RGPD et du règlement européen sur l'IA, il faudra les obtenir avant que Koa n'apparaisse dans le Setup des clients européens.
Samedi, le patron d'Anthropic appelait les labos à ralentir. Mardi, l'un de leurs plus gros clients montrait qu'il construisait son propre modèle, au cas où. Il s'appelle Koa, « courage » en hawaïen. C'était le nom du golden retriever de Benioff, que l'entreprise présente depuis des années comme sa mascotte, avec le titre de « Chief Love Officer ».
Reasoning model - modèle qui, avant de répondre, déroule son raisonnement étape par étape et choisit ses outils, au lieu de répondre tout de suite. Post-training - entraînement complémentaire d'un modèle pré-entraîné pour des tâches précises, moins cher qu'un entraînement à partir de zéro. Frontier - les modèles les plus puissants du moment, ici GPT-5.5 et Claude Opus 4.8. Agentforce - la plateforme de Salesforce pour construire des agents IA ; la facturation se fait entre autres à la conversation (2 dollars) ou à l'action (10 cents).